AlgaGain
Information Extraction
Dati utili chiusi in documenti, immagini e audio?
AlgaGain li estrae e li classifica, anche quando sono scritti nel linguaggio del vostro settore, con sigle, termini ed eccezioni, e li porta in database e gestionali. Per ogni dato si sa da dove viene e quale regola l’ha trovato.
La demo si richiede ad AGG Soluzioni Avanzate, che commercializza la piattaforma: si apre il suo sito.

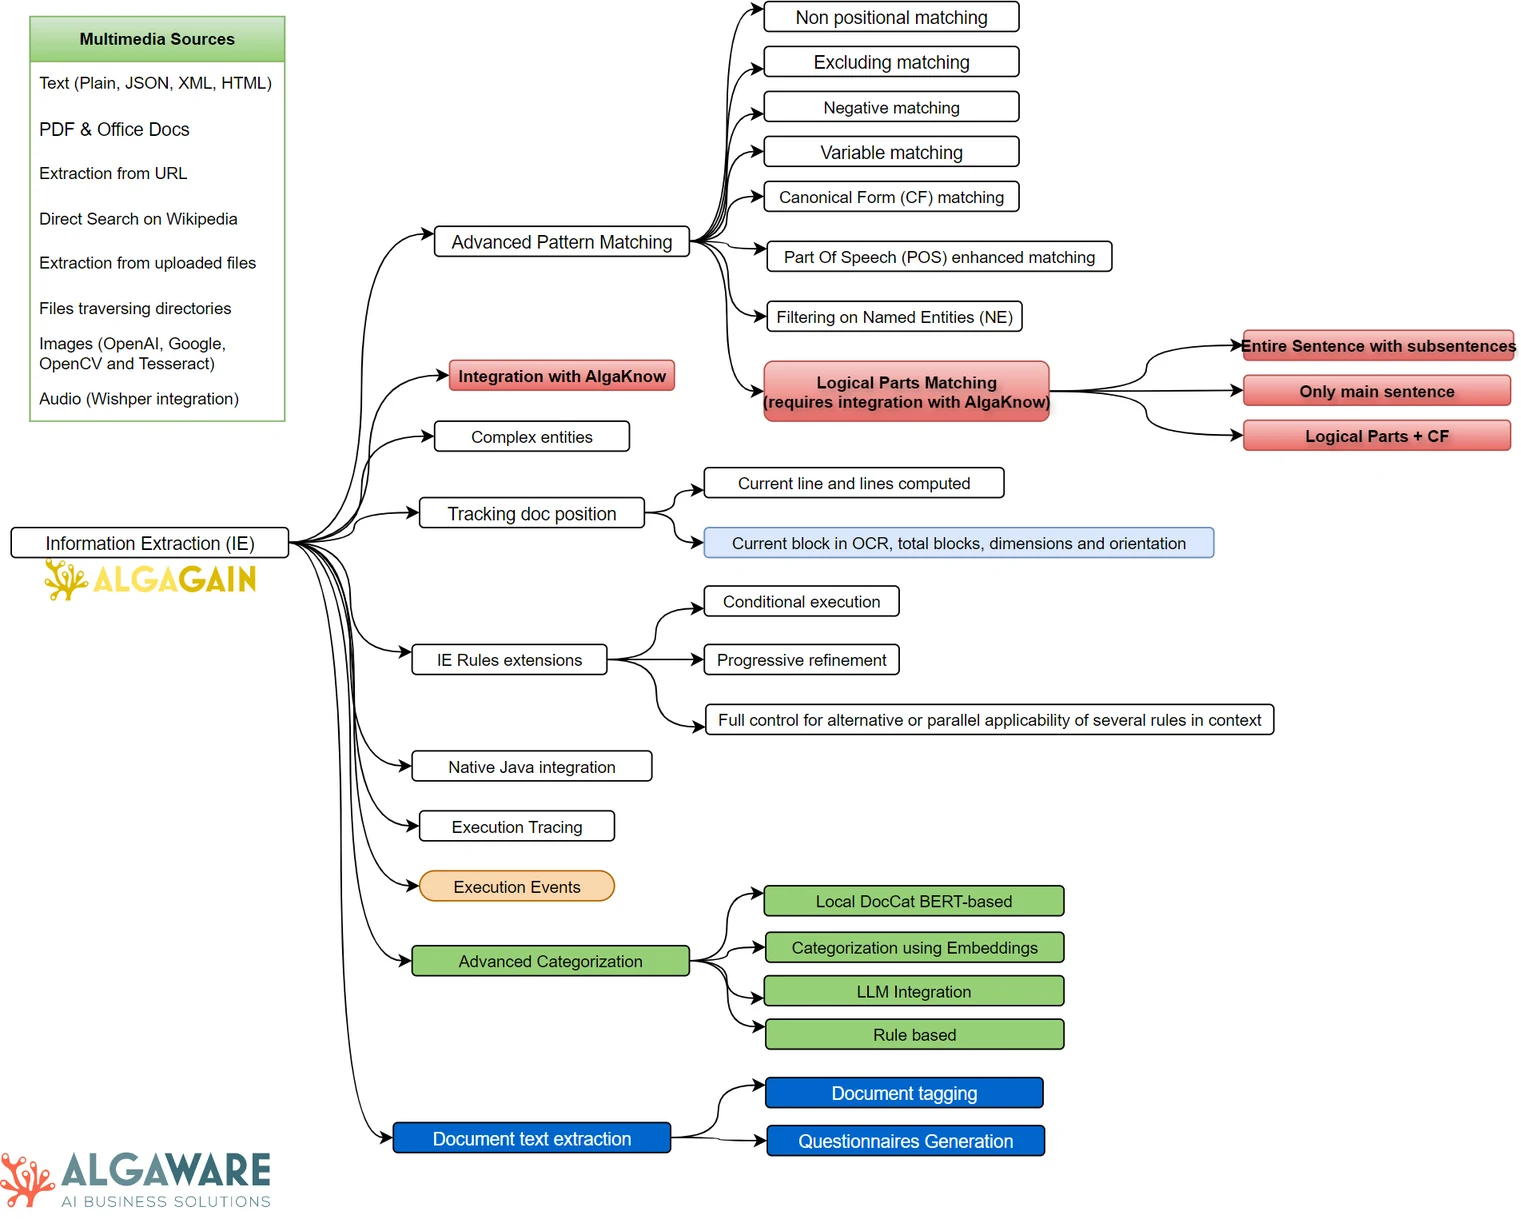
Da quali fonti
Come estrae
Navigare il documento
Le regole si muovono nel documento in modo strutturato (righe, blocchi, orientamento) e trovano relazioni di posizione anche complesse: il valore accanto a un’etichetta, sotto un titolo, nello stesso riquadro.
Tutte le forme di una parola, in modo ripetibile
“Pagare” trova “pagato” e “pagheremo” grazie al dizionario morfologico, non a un’ipotesi del modello: lo stesso risultato ogni volta, e se serve con la parte del discorso (verbo o nome). Gli LLM si aggiungono dove servono, non al posto delle regole.
Parti logiche della frase
Ben oltre soggetto, oggetto e frase principale, con AlgaKnow.
Entità complesse
Riferimenti normativi, codici, importi, date.
Raffinamento progressivo
Regole alternative o in parallelo, attivate dal contesto.
Tutto tracciato
Ogni estrazione con la regola che l’ha prodotta.
Classificare
Troppe categorie e pochi esempi?
Più approcci insieme, scelti caso per caso.
Regole
Precise e spiegabili, per i criteri noti.
Classificatore locale
Un modello che gira sui vostri server.
Somiglianza
Il confronto con documenti già classificati.
LLM
Solo per i casi più difficili.
Approcci a confronto
Estrazione di dati da immagini di documenti.
| OCR + regole | OCR + LLM | Solo LLM | OCR locale | |
|---|---|---|---|---|
| Velocità | ~10 s | ~23 s | ~15 s | ~7 s (solo lettura) |
| Accuratezza | massima | elevata | elevata | elevata |
| Costo | molto basso | alto | basso | hardware locale |
| Rischio di allucinazioni | molto basso | basso | medio-basso | medio-basso |
| Dati sensibili | pseudonimizzazione o contratto | pseudonimizzazione o contratto | pseudonimizzazione o contratto | restano in azienda |
| Flessibilità | media | alta | altissima | media |
Un OCR sbaglia, un LLM allucina: per questo i controlli simbolici servono in tutti i casi.
Oltre l’estrazione
Etichettatura
Etichettatura automatica dei documenti.
Questionari
Generazione di questionari dai documenti: prototipo funzionante, da sviluppare su progetto.
Un caso: dati da foto di documenti
Oltre il 94% di letture esatte di codici fiscali, POD e PDR da foto scattate col cellulare.
Approfondimento tecnico
- Fonti: testo, JSON, XML, HTML; PDF e Office con Apache Tika; estrazione da URL; ricerca diretta su Wikipedia; file caricati e attraversamento di cartelle
- Immagini: OCR con Tesseract, OpenCV e servizi cloud (OpenAI, Google); audio con Whisper
- Regole: corrispondenze non posizionali, esclusioni, negazioni, variabili, forma canonica, parti del discorso, parti logiche (frase intera con subordinate o solo principale), filtri sulle entità, esecuzione condizionale
- Posizione: riga corrente e righe calcolate; blocco OCR, numero di blocchi, dimensioni e orientamento
- Estensioni delle regole in Java; tracciamento dell’esecuzione; eventi per la pre-elaborazione specifica del progetto
- Classificazione: regole, classificatore locale basato su BERT, somiglianza in un vector store, LLM
Mettete alla prova AlgaGain
Demo e progetti con AGG Soluzioni Avanzate, che commercializza la Piattaforma Algaware in Italia.